Gestern stand die Abschlusspräsentation meines Programmierpraktikums an, die sehr erfolgreich verlief. In den nächsten Tagen werde ich dann auch die Ausarbeitung meines Programmierpraktikums online stellen.
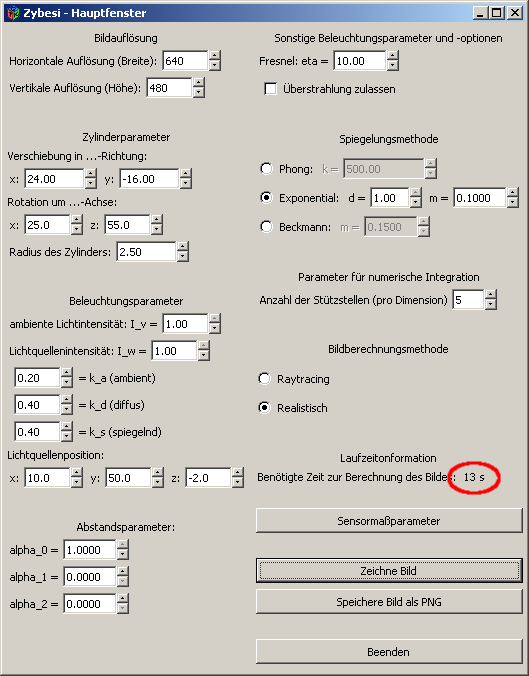
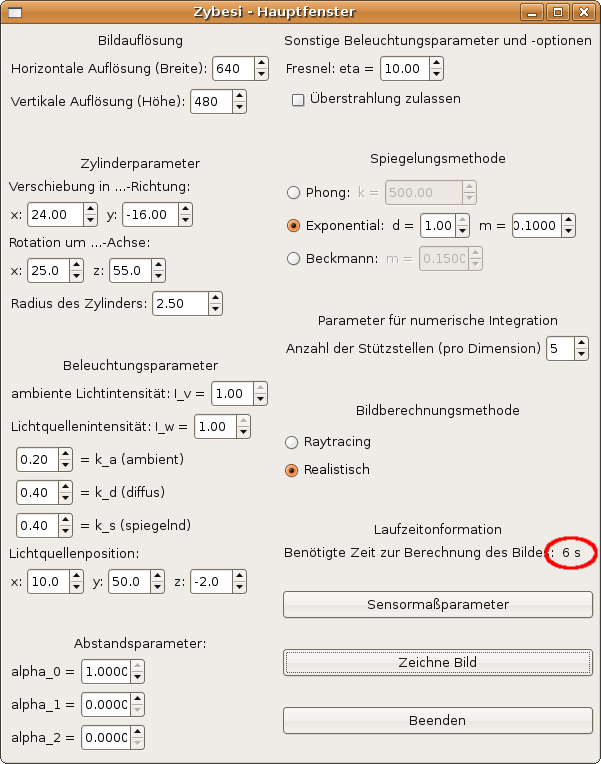
Bei der Vorbereitung der Präsentation ist mir noch was aufgefallen, was auch in der Ausarbeitung keine Erwähnung mehr findet. Entwickelt hab ich mein Simulationstool hauptsächlich unter Windows, die Präsentation der Software habe ich jedoch unter Linux gemacht. Dabei ist mir aufgefallen, dass die Erstellung der Simulationsbilder unter Linux (unterer Screenshot) wesentlich weniger Zeit beansprucht als unter Windows (oberer Screenshot), was folgende beiden Screenshots illustrieren sollen.
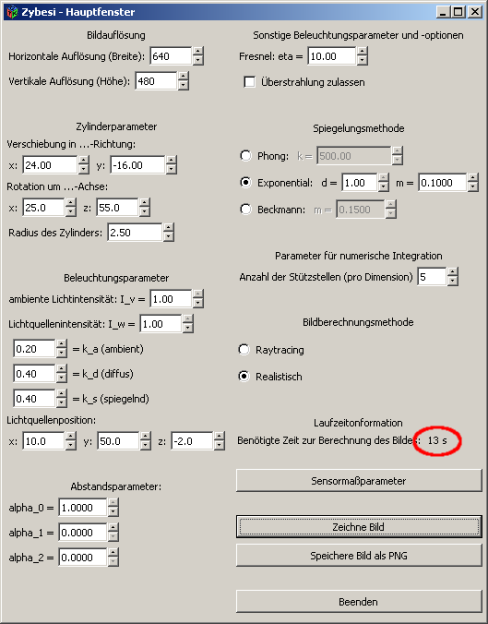
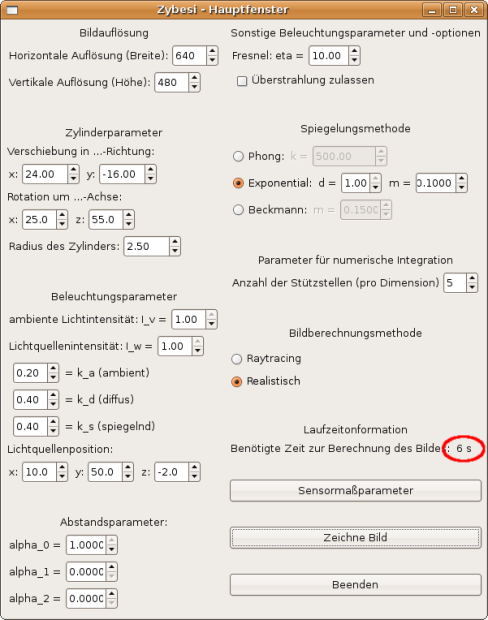
Zwar werden die Laufzeiten auf ganze Sekunden abgerundet, aber man sieht, dass die Ausführung unter Windows (oberer Screenshot) sage und schreibe doppelt so lange dauert wie unter Linux (unterer Screenshot). In meinem Fall handelt es sich um die Distribution Ubuntu).
Dabei wurde beide Male haargenau der selbe Zylinder simuliert mit exakt den selben Form-, Lage-, Beleuchtungs- und Modellierungsparametern. Beide Male wurde die Software mit gcc kompiliert mit absolut identischen Compileroptionen. In keinem der beiden Testläufe waren zusätzliche Programme geöffnet, die Prozessor oder Speicher hätten auslasten können. Auch das Testsystem, mein Notebook, war beide Male das gleiche.
Zwar handelte es sich bei meiner Windows XP Professional Version um die 32-Bit Variante und bei Ubuntu um die mit 64-Bit Unterstützung, das dürfte aber nur einen Unterschied bei der Genauigkeit der Berechnungen, jedoch nicht bei deren Geschwindigkeit machen. Auch die Tatsache, dass nur die Windows Version das Abspeichern von PNG-Dateien unterstützt, dürfte keinen Unterschied machen, da dieses Abspeichern explizit ausgeführt werden muss und nichts mit dem eigentlichen Bildberechnungsprozess zu tun hat. Da es sich bei der CPU in meinem Notebook (einem AMD Athlon-64 3000+) um eine Singlecore CPU handelt, kann auch eine eventuell betriebssystemabhängige Schleifenparalellisierung (in der aktuellen Version ist Zybesi keine Multithreadanwendung), für die wirklich einiges Potential in meiner Software vorhanden ist, nicht schuld an den massiven Leistungsunterschieden sein. Auch habe ich darauf geachtet, dass die CPU sowohl unter Windows als auch unter Linux auf maximalem Arbeitstakt läuft und sich nicht in irgendeinem Stromspamodus befindet und sich somit automatisch herunter taktet.
Das soll jetzt natürlich nicht heißen, dass Linux das bessere (oder zumindest schnellere) Betriebssystem ist, aber eine Erwähnung in Form dieses Blogeintrags war’s mir dann doch wert.
Nachtrag („Wer lesen kann ist klar im Vorteil“ oder „Wikipedia ist (meistens) dein Freund“):
Jetzt habe ich doch noch die Lösung für den großen Geschwindigkeitsunterschied bei den Berechnungen unter den beiden Betriebssystemen gefunden. Den weitaus größten Teil der Berechnungen in meinem Simulationstool machen Skalarprodukte von Vektoren aus, also im Prinzip Additionen und Multiplikationen von Gleikommazahlen. Bei der AMD64-Architektur, die die x86-Architektur und den x86-Befehlssatz erweitert und über die meine Notebook-CPU verfügt, sind zwei Faktoren entscheidend für den Performanceboost, den ich festgestellt habe.
- Im 64-Bit Modus stellt die AMD64-Architektur 16 zusätzliche Register zur Verfügung, die bei der Ausführung von 32-Bit Anwendungen auf der selben CPU nicht zugänglich sind.
- Hauptunterschied für den Geschwindigkeitsunterschied dürfte jedoch sein, dass die AMD64-Architektur für Gleitkommaoperationen nicht auf die x86-FPU zurück greift, sondern stattdessen die entsprechende SSE-Einheit benutzt. Diese ist von Haus aus performanter als die x86-FPU. Größter Vorteil der SSE-Einheit ist die Tatsache, dass deren Register, in denen die Operanden für eine Berechnubg stehen, 128 Bit breit sind. Im Gegensatz dazu sind die Register der x86-FPU nur 80 Bit breit.
In ein Register der SSE-Einheit passen also vier Gleitkommazahlen einfacher Genauigkeit oder zwei Gleitkommazahlen doppelter Genauigkeit. Der Clou ist nun, dass die SSE-Einheit tatsächlich pro Verarbeitungschritt jeweils zwei Gleitkommazahlen doppelter Genauigkeit aus zwei Registern nehmen kann und so in einem Schritt zwei Gleitkommaberechnungen durchführt. Dies dürfte wohl die doppelte Ausführungsgeschwindigkeit der Bildberechnung unter Linux im 64-Bit Modus erklären.
Wer das alles mal selbst durchlesen möchste, dem empfehle ich die beiden Wikipedia-Artikel zu AMD64 und SSE, aus denen ich diese Informationen habe.

 Dem Deutschen wird ja nachgesagt, dass er die Bürokratie praktisch erfunden hat. Und aus viel Bürokratie kann man auch mehr oder weniger sinnvolle Statistiken basteln. Einige der Letzteren lese ich ab und zu recht gern und bin dabei auf ’nen recht
 War neulich auf’m tittlinger Wertstoffhof um brav unseren recycelbaren Hausmüll dort abzuliefern. Da ich das öfters mache, bin ich’s schon gewohnt, dass die Container für die Haushalts- und normalen Elektrogeräte von Osteuropäern besetzt sind, die gleich alle technischen Abfälle prüfen, ob sie die noch irgendwie verwerten können.
 Fleißige Leser meines Blogs kennen ihn schon, den „Nagus‘ all in!“. Für alle anderen kurz Zusammengefasst: Da


 Neben